
Tenk deg, i et eller annet møte, så er det noen som spør “har vi data om dette?”. Tre personer rekker opp hånda, “Ja, det tror jeg vi har!”. Men ingen er helt sikre på hvor de ligger, hva feltene egentlig betyr, eller om det er de samme dataene de tenker på. Møtet avsluttes, og en av beslutningene er å “finne ut av det”. Så skjer det ingenting!
Dette forsøker rammeverket orden i eget hus å gjøre noe med. Blant annet!
Hva er orden i eget hus?
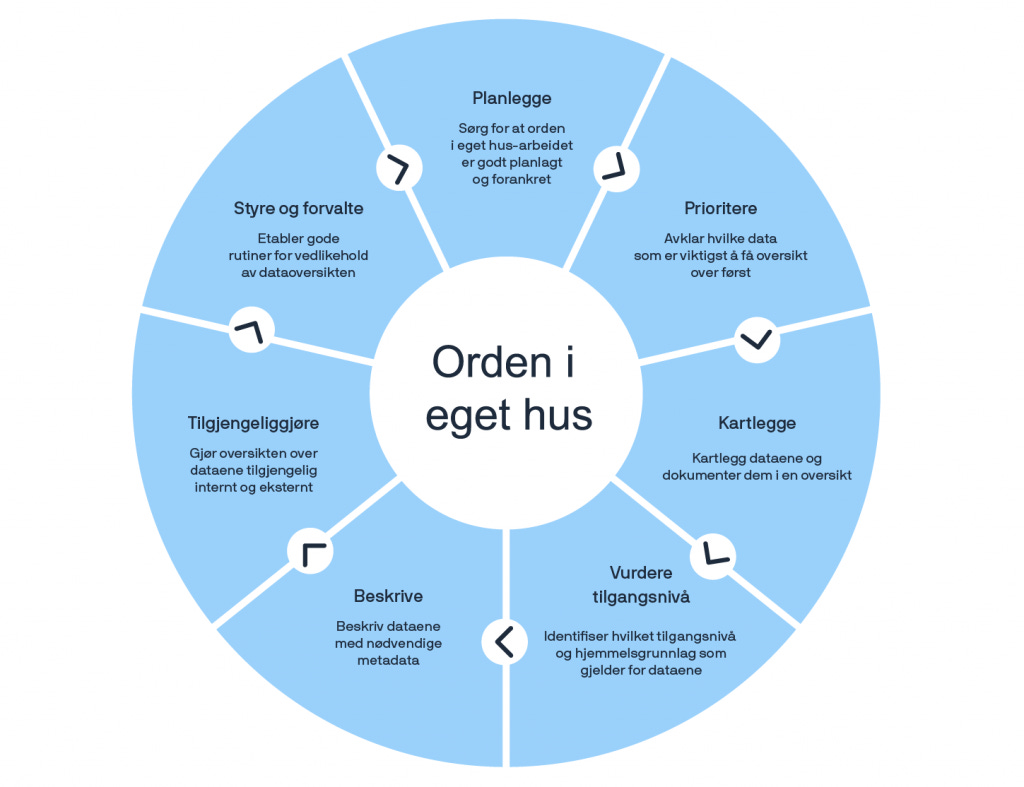
Orden i eget hus er et rammeverk utviklet gjennom et samarbeid fra flere virksomheter i norsk offentlig sektor, og som forvaltes av Digitaliseringsdirektoratet (Digdir) for å hjelpe deg med å få kontroll på egne data. Målet er at en virksomhet skal kunne dele og gjenbruke data. Dele og gjenbruke med seg selv, andre offentlige etater, og med samfunnet (både nasjonalt, og internasjonalt). På en måte som er pålitelig, forståelig og bærekraftig over tid.
Rammeverket er bygget rundt fire kapabilitetsnivåer:
Ha oversikt: vet du hvilke data virksomheten har, og hvor de er?
Beskrive: er dataene dokumentert med standardiserte metadata som andre kan forstå?
Tilgjengeliggjøre: kan andre faktisk finne og bruke dataene, internt eller eksternt?
Bruke: tas dataene aktivt i bruk, og bidrar de til verdiskaping?
Dette er iterative prosesser som kan kjøres parallelt. Ingen av stegene er disjunkte, og det er definitivt ingen fossefallsmodell.
Hva orden i eget hus ikke er
Orden i eget hus er ikke en teknologistandard, rammeverket forteller deg ikke hvilke systemer du skal bruke. Det er et rammeverk for å skape en praksis rundt datastyring, og modenhet dataforvaltning, der teknologi er et hjelpemiddel.
Det er heller ikke en nøkkelferdig hyllevare. Noen starter med å anskaffe en katalogløsning, og tror at de er i gang. Men en katalog uten forvaltningspraksis er vel bare et tomt skjema? Det er menneskene, ansvarsforholdene og rutinene som gjør en katalog nyttig. Datastyring der, altså.
Og, hah! Dette er ikke (bare) et IT-prosjekt, det er heller ikke (bare) et informasjonsarkitekturprosjekt. Det er strategi! Hvem eier dette datasettet? Hvem har mandat til å definere hva et begrep betyr? Hvem bestemmer hvem som får tilgang?
Konteksten som datastyring opererer i, har endret seg fundamentalt. Dagens virksomheter opererer i økende grad i det som kan beskrives som et distribuert datalandskap: et sosioteknisk system bestående av flere uavhengige beregningsmessige og organisatoriske noder som kommuniserer med hverandre.1
Data Governance at the Socio-Technical Core — Winfried Adalbert Etzel
Forholdet til standarder og fellesløsninger
Orden i eget hus henger tett sammen med noen konkrete nasjonale standarder og løsninger. De viktigste er kanskje:
DCAT-AP-NO (Data Catalog Vocabulary): norsk applikasjonsprofil for W3Cs DCAT-standard, denne brukes til å beskrive datasett på en strukturert og maskinforståelig måte.
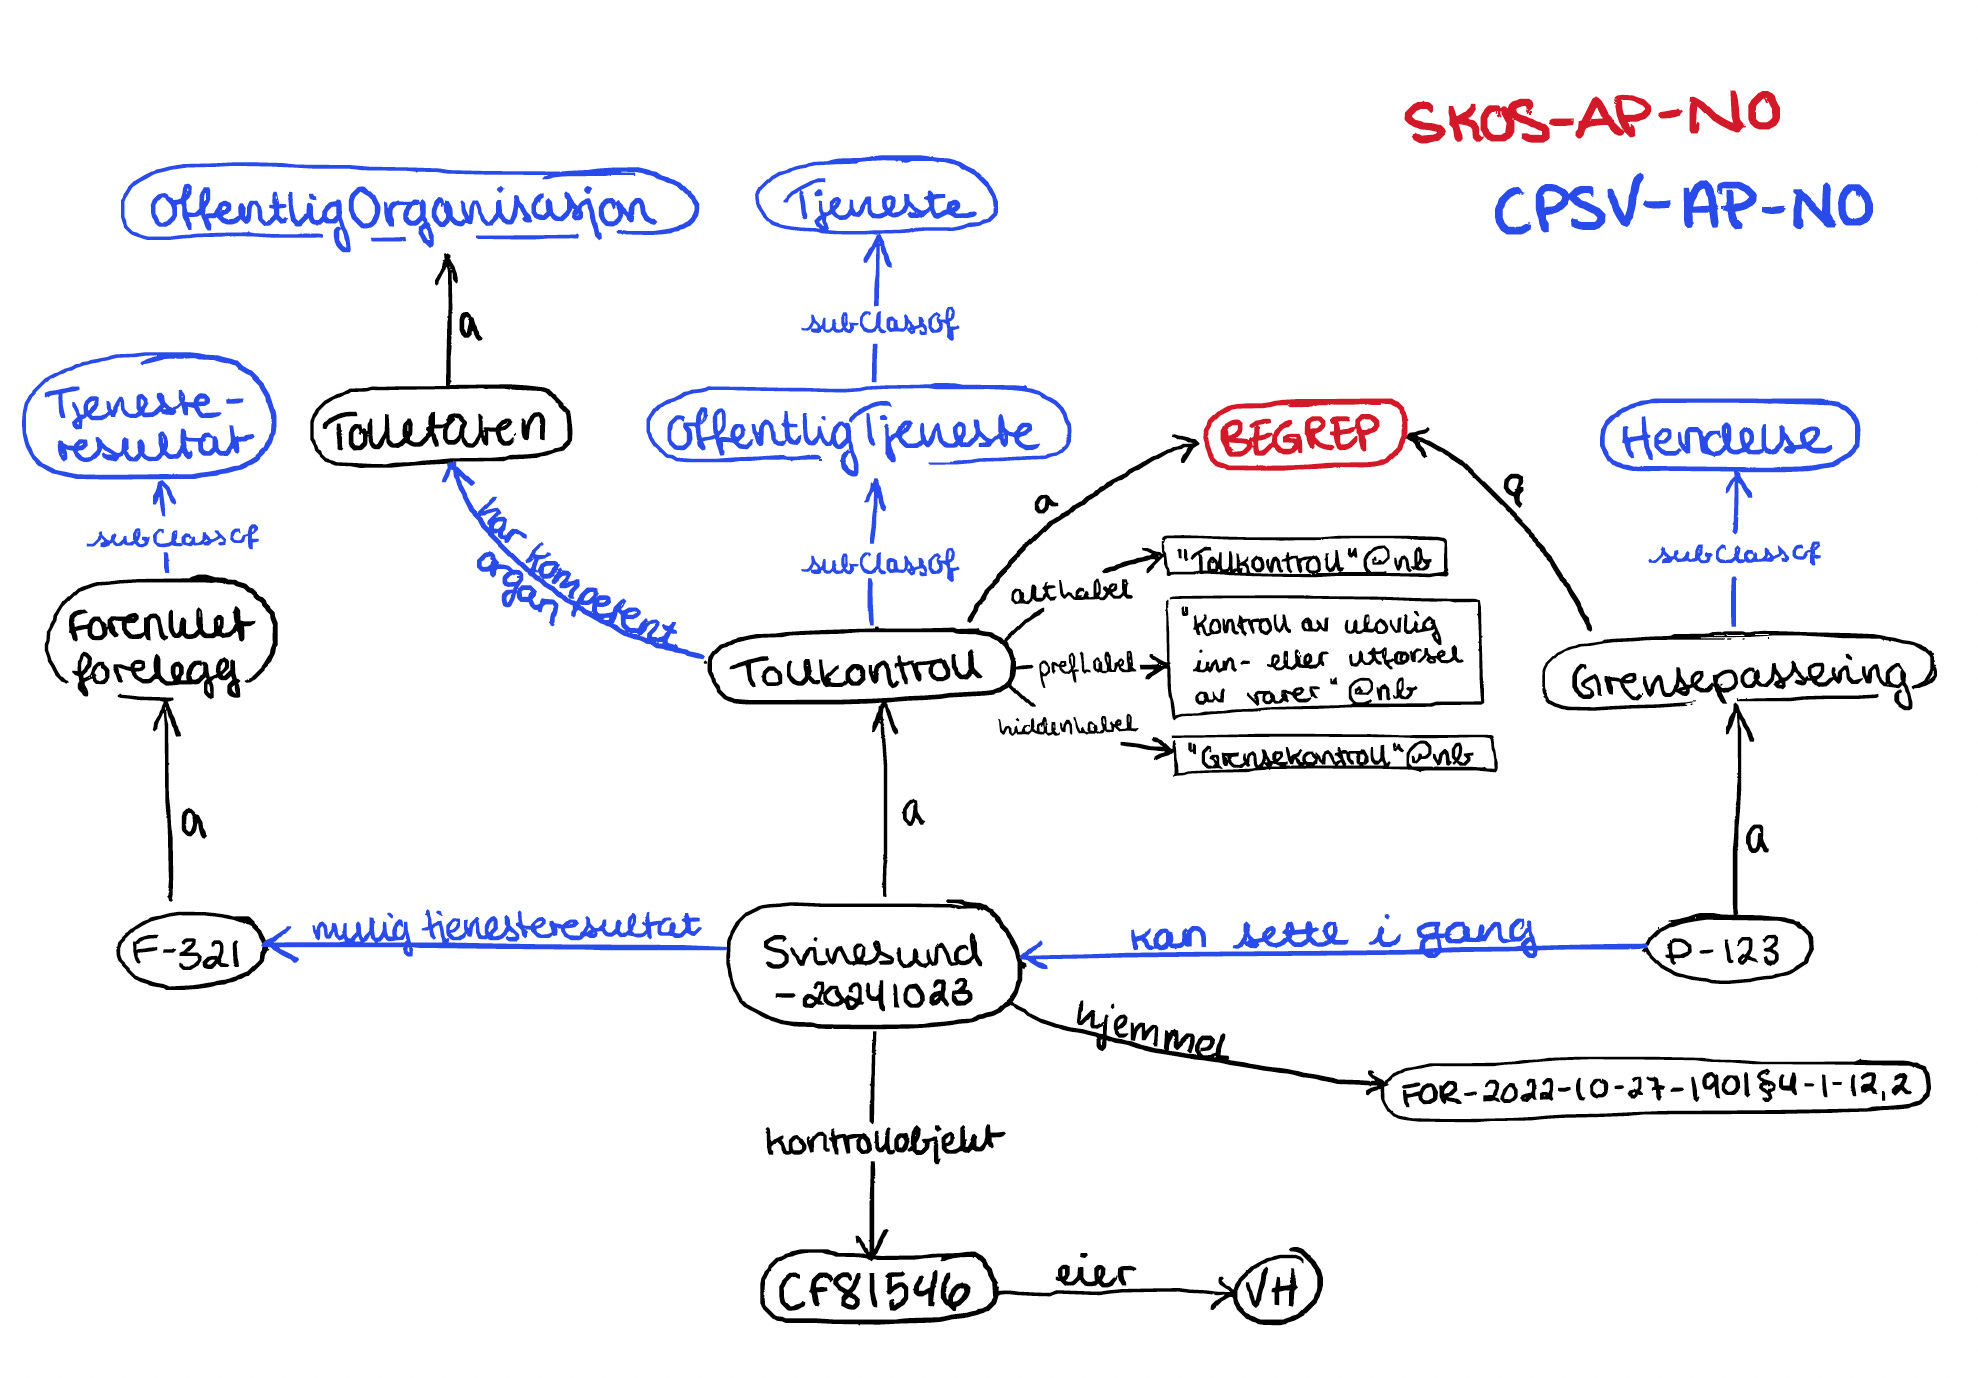
SKOS-AP-NO (Simple Knowledge Organization System): standard for å beskrive begreper, hva ordene og feltene i datasettet (og kunnskap i organisasjonen ellers) faktisk betyr.
CPSV-AP-NO (Core Public Service Vocabulary): standard for å beskrive offentlige tjenester og hendelser i innbyggernes og virksomhetens liv. Særlig relevant for etater som tilbyr tjenester (og det er temmelig mange) og ønsker å beskrive hva de gjør, ikke bare datainnhold.
Felles datakatalog (data.norge.no): nasjonal plattform for publikasjon av datasett- og begrepsbeskrivelser, slik at andre kan finne de.
Det er disse standardene som gjør at beskrivelser kan gjenbrukes. Det er disse standardene som underbygger samhandling; internt, nasjonalt og internasjonalt. Dette er F(indable), A(ccessible), I(interoperable), and R(eusable) data!
Fallgruver
Det er lett å rote seg bort, ved å…
…løse alt på en gang
Det er fort gjort å tenke at man skal ta alt i én jafs. Det er en rimelig stor prosess å kartlegge hele dataporteføljen. Kanskje ha man en rapport etter et halvt år, men ingen endret praksis. Orden i eget hus er en gradvis oppbygging av kapabilitet, og ikke noe kartleggingsprosjekt.
…starte med teknologi før forvaltning
En katalog er fint og flott, men nytten kommer først når man vet hvem som skal fylle den, hva som skal inn og hvem som er ansvarlig for at innholdet er korrekt. Teknologi uten forvaltning blir fort bare surr.
…undervurdere det organisatoriske
“Hvem er dataeier?” Enkelt spørsmål, eller? Ikke egentlig. I flere virksomheter er dette uavklart. Det å få dette avklart krever beslutninger som treffer myndighet, ansvar og ressurser.
Verktøy != praksis?
Felles datakatalog er et toppers hjelpemiddel, men det å ha publisert noen datasett eller begrep er ikke det samme som å ha orden i eget hus. Men det er et godt utgangspunkt!
En praktisk inngang
Så, hvordan kan man komme i gang?
Et domene man kjenner godt
Ikke start med alt! Start med ett domene, gjerne et som er relativt “modent” i virksomheten. For eksempel et register man bruker daglig, en datakilde du vet mye om, eller et system som mange er avhengige av.
Vi starter med noen enkle spørsmål: Hva er dette, egentlig? Hva betyr feltene? Hvem kan svare på det? Hvem bruker dataene, og til hva?
Poenget med å starte smått er å erfare hva god dataforvaltning innebærer i praksis, i din virksomhet og med dine folk, før man skalerer.
Avklar eierskap og ansvar
For hvert datasett (eller gruppe av data) trenger dere svar på noen grunnleggende spørsmål:
Hvem er dataeier? Den som har det faglige og strategiske ansvaret?
Hvem er dataforvalter? Den som har det operative ansvaret for kvalitet og tilgang?
Hvem produserer dataene, og hvem er de viktigste konsumentene?
Dette er nok litt vanskeligere enn hva det høres ut som. Dette krever dialog, og i noen tilfeller beslutninger fra ledelsen. Men det er nødvendig, for uten et klart eierskap vil ingenting bli vedlikeholdt over tid.
Beskrive før automasjon
Det er fristende å automatisere metadata-innhøsting tidlig, særlig hvis man har teknisk kapasitet til det. Men hvis man ikke er enige om hva begrepene betyr, vil det fort bli surr i maskineriet.
Lag en enkel begrepsmodell for domenet dere jobber med. Trenger ikke være allverden i starten. Store papirark og fargeblyanter har vært mitt verktøy i mange år, ellers kan nesten hva-som-helst benyttes for beskrivelse av begrep. Hva heter tingene? Hva betyr de? Er det synonymer eller overlappende begreper som brukes ulikt på tvers av avdelinger?
Når dette er på plass, så kan det struktureres iht. DCAT-AP-NO og SKOS-AP-NO, og etterhvert publiseres på Felles datakatalog.
Hva med kunnskapsgrafer, da?
Orden i eget hus handler primært om forvaltning og beskrivelse. Men etterhvert som beskrivelser modnes kan man jo lure på om disse beskrivelsene kan brukes til mer enn dokumentasjon?
Her begynner veien mot semantiske teknologier! Og den er ikke så lang som du kanskje skulle tro.
DCAT og SKOS er begge bygget på RDF, en W3C standard for å uttrykke informasjon som relasjoner mellom ting. Det betyr at virksomheter som følger orden i eget hus allerede er i ferd med å produsere lenkede data, de kaller det bare ikke det!
Når et datasett ikke bare er beskrevet, men også har maskinlesbare (og maskinforståelige) begrepsdefinisjoner, eksplisitte relasjoner til andre datasett, og formelle valideringsregler, begynner det å ligne det som kalles et semantisk dataprodukt: en dataenhet som bærer sin egen kontekst og er utformet for å kunne kombineres med andre.
En kunnskapsgraf er infrastrukturen som gjør dette mulig i stor skala. I stedet for punkt-til-punkt-integrasjoner der hvert system må “oversette” til hver annet, kan semantisk rike beskrivelser fungere som et felles, maskinlesbart lag som ulike systemer kan spørre mot.
Det er kjekt å vite at orden i eget hus peker i en retning, og at de åpne standardene man allerede bruker (DCAT, SKOS, CPSV, RDF) er de samme standardene som kunnskapsgrafer bygger på. Det er ingen hard grense mellom orden i eget hus og semantisk infrastruktur. Gradvis modning langs den samme aksen der altså.
Hva med KI, da?
KI her og KI der. Joda, det er massevis av potensiale med å slenge KI på egne data. Men det som er litt kinkig er at en språkmodell som slippes løs på ustrukturerte, udokumenterte, flertydige og eierløse data produserer svar som høres troverdige ut, men som er nærmest umulige å etterprøve. Vi har jo et og annet eksempel på dette fra norsk offentlig sektor.
For at KI-verktøy skal gi pålitelige, etterprøvbare og nyttige svar, trenger de å ha tilgang på data som er:
Veldefinerte: begrep har kjent og avklart betydning (semantikk).
Kontekstualisert: data er koblet til informasjon om hva de beskriver, hvem som har produsert dem, og under hvilke betingelser (lenkede data med relasjonen i sentrum).
Eid: det finnes noen som kan si om et svar er riktig eller galt.
Dette kan ikke KI-løsninger fikse selv, men orden i eget hus hjelper til å bygge dette.
Virksomheter som prioriterer semantikk i KI-klare data, vil øke nøyaktigheten til agentisk KI med opptil 80 % og redusere kostnadene med opptil 60 %.
— Gartner: Ontologies Are Crucial to Improve AI Accuracy and Reduce Costs (Jaffri & García-Rodeja, May 2026)
En virksomhet som har veldefinerte begreper i SKOS-AP-NO, veldokumenterte datasett i DCAT-AP-NO, og avklarte eierforhold har lagt grunnlaget for at et KI-system kan brukes på en måte som faktisk kan stoles på. Uten dette blir KI fort et verktøy for å produsere raskere og mer overbevisende feil.
I april i år holdt jeg et innlegg på Faglig arena for datadeling og informasjonsforvaltning om nøyaktig dette tema. Det finnes et opptak for de som er interesserte.
Orden i eget hus som praksis
Når oppnår man egentlig suksess?
Det finnes ikke et tidspunkt for man er “ferdig” med orden i eget hus. Data og kunnskap endrer seg. Systemer skiftes ut. Nye behov oppstår. Virksomheter som lykkes er de som behandler dataforvaltning som en kontinuerlig praksis. Noe som vedlikeholdes og videreutvikles, og ikke noe avgrenset med en bestemt sluttdato.
Det viktigste første steget er ofte det enkleste å se, og det vanskeligste å faktisk gjøre; å begynne å snakke om data som noe virksomheten forvalter, ikke bare noe den har. Det skiftet i perspektiv—fra data som biprodukt til data som ressurs med eierskap og ansvar—er kjernen i hva orden i eget hus forsøker å bygge.
Med orden i eget hus kan vi bygge smartere løsninger for innbyggerne, spare skattepenger i form av redusert saksbehandlingstid, skape simuleringer for beslutningsstøtte og skape et lag for KI slik at KI slutter å tulle så fælt.
Start smått, lær, bygg!
Videre lesning
Fra forfatteren: The Living Knowledge Graph: Durability, Roles and Who Owns the Meaning
Digdir: Veileder for orden i eget hus
Om forfatteren

Ontologispesialist som koder i C, Java og Python. Arbeidet med kunnskapsrepresentasjon i over et tiår, og hatt innlegg om tema over hele verden. Spesialist i kunnskapsgrafer i Data Treehouse. Forfatter av SHACL for the Practitioner og anerkjent blant Norges Topp 50 Kvinner i Tech 2024.
Forfatteren har tatt seg friheten i å oversette sitatet til norsk.